펌핑 없이는 버틸 수 없네. 생각만큼 자주 하지는 않았네.
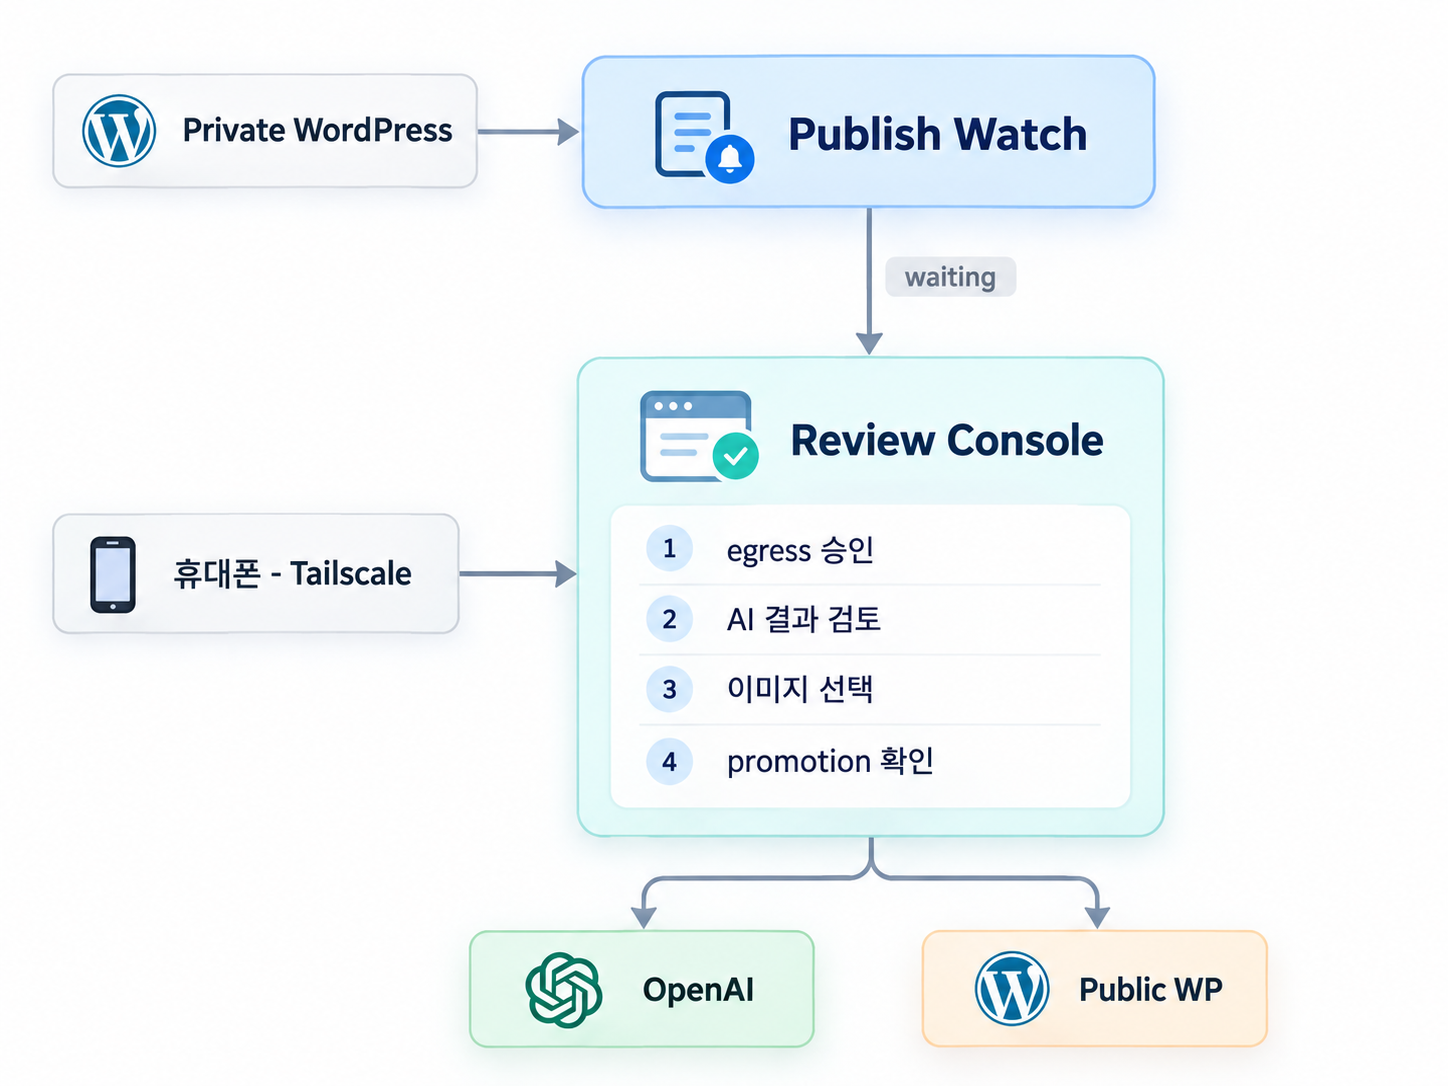
진척 속도가 확실히 빠르다.
거의 하나의 시스템을 만드는 수준인데, 게다가 놓치기 쉬운 테스트나 보안 문제도 잡아가며 해나가고 있다.
다만 자칫하면 내가 이해할 수 있는 범위를 초월하기가 쉬운데,
그럴 때마다 다른 중립적인 AI 세션을 통해 토큰을 소비할 수밖에 없게 되고,
게다가 영감이 떠오르지도 않았는데 이렇게 테스트를 위해 억지로 글을 작성하는 등, 주객전도가 되기도 쉽다.
근데 뭐, 아직까진 재밌는 걸.
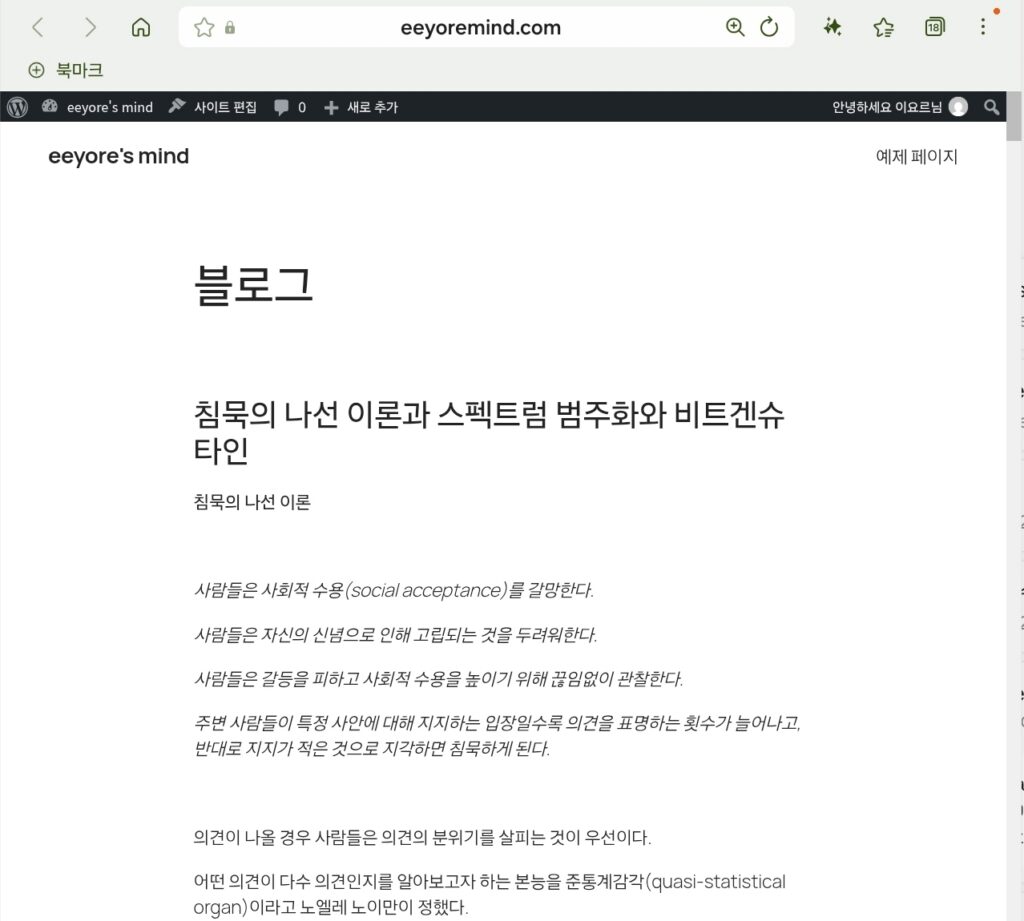
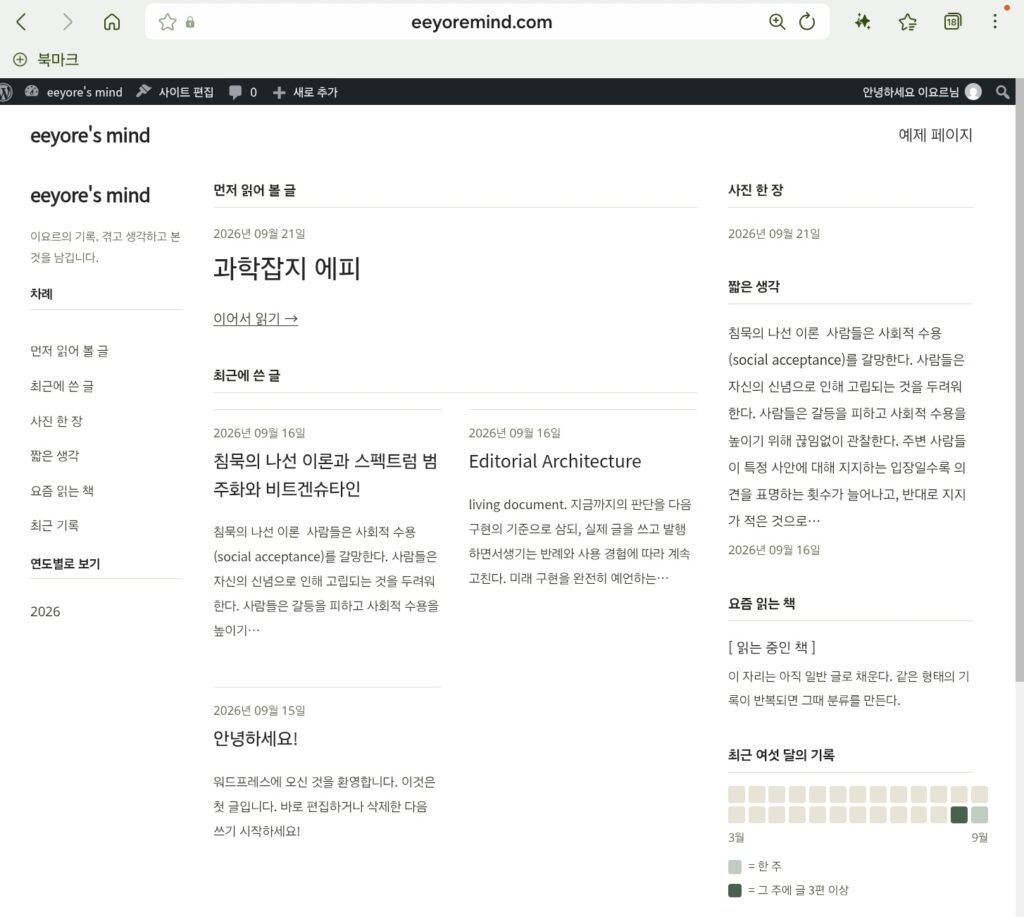
블로그를 만들고 있다.
오랜 숙원이라고 볼 수도 있는데, AI가 충분히 발전할 때까지 기다려왔고, 이제 때가 됐다는 판단에서 진행하고 있는데 무척 재미있다.
몇 가지 핵심 아이디어가 있는데,
정도가 지금까지다.
‘왜 이걸 만들까?’ 하는 이유 중의 하나가 내가 나중에 사라지더라도 순간의 나의 생각이 담겨있는 공간이 하나 있다는 것이 하나고,
나 자신이 참조할 수 있는 공간이 필요한 것이 둘째,
가감없이 일기처럼 컨텐츠를 생산하더라도 그것을 간접적으로나마 읽을 수 있도록 생산되게 만드는 파이프라인 확보가 셋째다.
변화없이 다니던 독서모임에 계속 다닌지도 꽤 오래됐는데, 예전만큼 심리적 여유가 없어서 가슴뛰는 다른 무엇인가를 찾아다니지 못하는 이유도 있을테고, 모임이 그 자체를 혹은 나를 심폐소생시키는 이유도 있겠고, AI가 나를 매료시키고 있어서라는 이유도 있겠다.
또 하나라면, 이전과는 다른 구조로 내 인생이 변화되는 것도 있을테고.
그것은 내가 아직도 말로 표현할 수 없는 ‘렌즈’를 주었고,
그것은 나를 둘러싼 모든 것들을 다시 의미부여하는 큰 영향력을 발휘했다.
어쨌든, 나는 결과적으로 2개의 블로그를 운영하게 된다.
public 블로그에서는 다양한 실험들이 이뤄질 수 있다.
계속 재미있기를.
침묵의 나선 이론
사람들은 사회적 수용(social acceptance)를 갈망한다.
사람들은 자신의 신념으로 인해 고립되는 것을 두려워한다.
사람들은 갈등을 피하고 사회적 수용을 높이기 위해 끊임없이 관찰한다.
주변 사람들이 특정 사안에 대해 지지하는 입장일수록 의견을 표명하는 횟수가 늘어나고, 반대로 지지가 적은 것으로 지각하면 침묵하게 된다.
의견이 나올 경우 사람들은 의견의 분위기를 살피는 것이 우선이다.
어떤 의견이 다수 의견인지를 알아보고자 하는 본능을 준통계감각(quasi-statistical organ)이라고 노엘레 노이만이 정했다.
이 말은 2025년 현재에 딱 맞아들어가진 않는다.
온라인 커뮤니티에서 양산/확대/재생산되는 방식은 20세기에서 예측될 수 없다.
그래서 반대로 다수가 침묵하고 소수가 온라인을 지배하는 방식이 다수 존재하기에, 우린 어렵지 않게 감각적으로 이해할 수 있다.
그래서 의견 분위기 지각(준통계감각) 그 자체만을 차용하기로 하고, 그 근거는 아이러니하게도 내가 지적하고자 하는 휴리스틱에 있게 된다.
스펙트럼 범주화
현실을 스펙트럼으로 인식하는 것은 피로하지만 필요한 일이라고 생각하여 요즘에 항상 쥐고 산다.
우리는 생각을 언어화하는 시점에서 이미 범주화가 결정되기 때문에, 말하는 시점에서 이미 스트레스를 받는다고 생각한다.
언어 자체가 이미 세계를 특정 방식으로 자르고 범주화한다는 것을 지적하는 이는 없으리라.
의견이 소수/다수를 넘어서서, 범주화되지 않았다면 – 즉, 표현 불가능하거나, 표현 불가능함을 설명하려는 시도 자체가 이미 과도한 인지적 비용(에너지)을 요구한다면 – 침묵하게 된다.
게다가 스펙트럼적 사고 자체가 ‘우유부단’하거나 ‘비실용적’으로 범주화되면, 그 사고를 드러내는 것 자체가 비판받을 수 있고 에너지도 많이 들기 때문에 더욱 강한 침묵을 유발하게 한다.
언어와 범주의 폭력성에 대해 이야기 할 바탕이 마련되었다.
“말할 수 없는 것에 대해서는 침묵해야 한다”
언어의 경계를 지적한 비트겐슈타인의 어깨로 올라가,
그 경계 위에서 생기는 오해와 침묵의 다의성에 집중을 해보자.
“슬프다”고 말하는 순간, 복합적인 감정이 ‘슬픔’이라는 범주도 강제된다.
누구도 빠르게 “60% 슬프고 20% 안도를 느끼며 15%의 공허함과 묘한 평온이 5% 감지된다”라고 하지 않는다.
표현력의 문제이기보다는 언어 구조의 한계이며, 엄청난 에너지가 소모되며, 대화가 이뤄지지 않는다.
우리는 범주화를 통한 의미상실 그 자체에 대해서는 받아들여야 한다.
하지만 “너의 의견은 무엇인가?”라는 행위는 그 자체로 에너지를 갈취하는 폭력이 될 수도 있음을 인지해야 한다.
침묵은 나약함도 회피도 아닐 수 있다.
의견을 물어보는 행위 자체가 중립적이지 않을 수도 있으며, 때로는 권위적일 수도 있음을 자각하며,
빠른 의사결정이 진일보가 아니라 진일퇴가 될 수도 있음을 알아야 한다고 생각한다.
living document. 지금까지의 판단을 다음 구현의 기준으로 삼되, 실제 글을 쓰고 발행하면서
생기는 반례와 사용 경험에 따라 계속 고친다. 미래 구현을 완전히 예언하는 명세가 아니다.쉽게 바꿔도 되는 것 — vocabulary, taxonomy 관계, 화면 표현, activity 계산 방식.
쉽게 흔들지 않는 것 — human-origin, Narrative Fidelity, Low-friction Authorship,
publicability 중심의 Privacy.
이 아카이브는 한 사람이 실제로 살아가며 얻은 경험·생각·관찰·탐구를 오래 보존하고,
그중 공개할 수 있는 것을 누구나 읽을 수 있는 이야기로 남기기 위한 시스템이다.
핵심은 많은 콘텐츠를 생산하는 것이 아니라 다음을 가능하게 하는 것이다.
Canonical Content의 출발점은 인간이다.
그 출처는 다음과 같은 것이 될 수 있다.
AI는 독립적인 콘텐츠 원천으로 간주하지 않는다.
AI가 최종 문장의 대부분을 작성할 수는 있지만, 그 글이 존재하게 된 이유와 그 안의 의미는
인간에게서 출발해야 한다.
정본에 이르는 두 경로는 모두 정상이다.
Human-origin source
   ├─→ Human write/review ─────────→ Canonical Content
   └─→ AI editorial → Human review → Canonical Content
AI 사용 여부는 provenance와 processing의 문제이지 콘텐츠의 인간 기원을 결정하는 기준이 아니다.
가장 중요한 작성 원칙은 다음과 같다.
Write first. Structure later.
글을 쓰는 순간에는 시스템의 분류 체계를 거의 의식하지 않아도 되어야 한다.
작성 시점에서 Type, Mode, Topic, Persona 등을 일일이 선택하도록 요구하지 않는다.
작성은 가능한 한 다음 정도로 가볍게 시작한다.
분류·구조화·공개 검토는 이후 단계에서 사람과 AI가 보조한다.
아카이브가 기록을 돕는 대신 입력 양식이 되어서는 안 된다.
현실은 그대로 기록되지 않는다.
사람이 일기나 블로그 글을 쓰는 순간 이미 선택·생략·압축·관점 설정·의미 부여·인과 해석이
일어난다.
따라서 AI Editorial Layer의 기준점은 현실 전체를 재구성한 가상의 사건 모델이 아니다.
기준점은 인간 저자가 경험을 해석해 작성한 서술이다.
Reality
  ↓
Human experience
  ↓
Human interpretation
  ↓
Authorial narrative
  ↓
AI editorial transformation
  ↓
Public narrative
작성된 인간의 서술이 존재한다면 AI가 raw material을 근거로 그것을 덮어써서는 안 된다.
AI는 새로운 서사를 만들어내는 것이 아니라 이미 존재하는 서사를 더 잘 전달해야 한다.
AI는 서사를 더 만들지 않는다. 이미 존재하는 서사를 더 잘 전달한다.
AI는 다음을 임의로 변경해서는 안 된다.
특히 극적 긴장감을 높이기 위해 없던 사건·대화·갈등·의도·복선·교훈을 추가하지 않는다.
문장이 부족하거나 독자가 이해하기 어려운 지점이 있다면 내용을 창작하기보다 부족한 부분을
지적하거나 보강을 제안한다.
공개된 글은 실제 맥락을 모르는 사람에게도 하나의 완전한 글이어야 한다.
동시에 실제 맥락을 아는 사람은 일부 디테일을 통해 추가적인 의미나 공명을 느낄 수 있다.
내부 맥락은 보너스여야지 해독 키여서는 안 된다.
이 아카이브는 공개 웹을 기본 전제로 한다.
특정 계정이나 social graph에 소속되지 않은 사람도 Canonical Content를 읽을 수 있어야 한다.
따라서 Privacy의 핵심 질문은
누가 이 글을 볼 수 있는가?
가 아니라
이 이야기는 공개 웹에 내놓을 수 있는 형태가 되었는가?
이다.
Privacy는 콘텐츠 분류축이 아니라 editorial constraint이자 publication gate다.
Private source / draft
        ↓
Privacy editorial review
        │
        ├─ 공개 불가 → private에 남음
        │
        └─ 공개 가능
              ↓
       Canonical publication
              ↓
            Public
공개하기 어려운 글을 친구·지인에게만 보여주기 위한 social graph나 friend ACL은 core
architecture에 포함하지 않는다. 정말 공개하면 안 되는 내용은 private source로 남긴다.
필요하면 정확한 날짜·위치·회사·학교·직책·나이·금액·프로젝트명처럼 재식별에 기여하는
identity coordinates는 일반화·생략·변형할 수 있다.
반면 서사의 질감을 만드는 디테일은 재식별 위험이 충분히 낮다면 가능한 한 보존한다.
목표는 무색무취한 익명화가 아니라 실제 경험의 질감을 보존하면서 공개 가능하게 만드는 것이다.
댓글의 로그인 여부, 익명 허용 여부 등은 별도의 interaction policy이며 Editorial Architecture의
핵심 문제로 다루지 않는다.
Canonical Content의 등록 허들은 낮게 유지한다.
필수:
필요:
다음은 발행 prerequisite가 아니다.
Canonical Content의 구조화 수준이 부족하다는 이유만으로 좋은 글의 발행이 막혀서는 안 된다.
Mode는 다음 질문에 답한다.
나는 이것과 어떤 방식으로 관계하고 있는가?
Topic이 대상을 설명한다면 Mode는 행동과 관계 방식을 설명한다.
Mode는 아카이브의 1급 탐색축이다.
Topic이 바뀌어도 한 사람이 세상과 관계하는 방식은 더 오랫동안 반복될 수 있기 때문이다.
단, 구체적인 Mode vocabulary는 미리 고정하지 않는다.Build / Explore / Read / Curate 등은 후보일 뿐이며 실제 콘텐츠가 쌓인 뒤 반복되는 행동
패턴을 보고 정한다. Mode 역시 작성 시 반드시 선택하지 않는다.
Topic은 다음 질문에 답한다.
무엇을 다루고 있는가?
Topic은 영구적인 관심사 선언이 아니다.
Topic은 시간에 따라 활성도가 변하는 기록상의 관심 대상이다.
Running, Coffee, Reading, AI, WordPress 같은 Topic은 모두 남아 있을 수 있지만 활성 시기는
다를 수 있다.
Topic에는 자연스럽게 다음 정보가 파생될 수 있다.
오래된 Topic을 삭제하지 않는다. 관심의 이동 자체가 아카이브의 일부다.
초기에는 Topic hierarchy를 강제하지 않고, 필요한 구조는 실제 콘텐츠가 쌓인 뒤 발견한다.
Persona는 미리 만들어 선택하는 캐릭터가 아니다.
독립된 허구 인격이나 공개 화자도 아니다.
Persona는 실제 한 사람에게서 특정 시간과 맥락에 걸쳐 여러 기록에 반복적으로 나타나는
관심·행동·관점·문제의식의 결합이다.
즉 Persona는 시간·맥락 종속적인 자기 패턴이다.
Write
 ↓
Unassigned
 ↓
콘텐츠 축적
 ↓
AI가 반복 패턴 발견
 ↓
Persona 후보 제안
 ↓
Human approve / merge / defer
AI는 예를 들어 다음처럼 제안할 수 있다.
최근 글 17편에서 이런 관점과 행동 패턴이 반복되고 있습니다. 하나의 Persona 후보로 묶어볼까요?
Persona는 입력 taxonomy라기보다 derived concept에 가깝다.
Persona에는 자연스럽게 생명주기가 존재한다.
Emerging
   ↓
Active
   ↓
Mature
   ↓
Dormant
   ↓
Revived
이는 캐릭터의 생명주기가 아니라 기록에서 관찰되는 자기 패턴의 활성도 변화다.
시간·환경·역할·관심 변화에 따라 Persona도 출현하고 사라지거나 다시 나타날 수 있다.
Persona가 없는 상태는 정상이다.
내부적으로는 persona = NULL을 유지하고, 공개 표현에서는 이를 기본 identity인 eeyore
아래 자연스럽게 보여줄 수 있다.
NULL과 eeyore라는 실제 Persona를 데이터상 동일하게 취급하지 않는다.
eeyore, ychvirus, Colin, Kevin, 창환, 해요르, 달요르처럼 자신을 부르는 이름과
Persona는 개념적으로 다르다.
필요하다면 향후 별도 모델로 분리할 수 있지만 초기 구현에서 반드시 구조화할 필요는 없다.
Type은 핵심 정체성 축이 아니다.
다음 질문에 답하는 보조 metadata다.
독자는 이 글을 어떤 종류의 문서로 읽어야 하는가?
같은 Topic과 Mode라도 생각을 따라가는 글, 작업 기록, 재현 가능한 가이드, 비교·리뷰,
짧은 노트는 서로 다른 읽기 기대를 만든다.
따라서 Type은 document form으로 본다.
Mode처럼 핵심 탐색축으로 승격하지 않으며 필수값도 아니다.
구체적인 Type vocabulary 역시 실제 콘텐츠가 쌓인 뒤 결정한다.
Time은 독립 taxonomy가 아니다.
모든 기록과 변화에 깔리는 공통 좌표다.
Time을 통해 Topic의 등장과 쇠퇴, Persona의 출현과 lifecycle, 관심사의 이동, 같은 주제를
바라보는 관점의 변화, 오랜 시간이 지난 뒤의 재등장을 읽는다.
필요한 경우 작성 시점, 발행 시점, 실제 사건 시점을 구분할 수 있지만 2026, 40대, 봄
같은 값을 별도의 분류 체계로 강제하지 않는다.
Canonical Content
│
├─ Mode        ← 1급 탐색축
├─ Topic       ← 시간에 따라 활성도가 변하는 관심 대상
├─ Persona     ← 시간·맥락 속에서 발견되는 자기 패턴
├─ Type        ← 선택적인 document form
└─ Time        ← 모든 변화의 공통 좌표
서로 다른 질문을 섞지 않는다.
Topic
→ 무엇을 다루는가?

Mode
→ 그것과 어떻게 관계하는가?

Persona
→ 특정 시기와 맥락에서 어떤 나의 패턴이 반복되는가?

Type
→ 어떤 형태의 글인가?

Time
→ 언제 일어난 변화인가?독자가 보는 콘텐츠 구조와 내부 편집 구조는 분리한다.
Reader-facing structure
├─ Mode
├─ Topic
├─ Persona
├─ Type
└─ Time

Internal editorial structure
├─ Provenance
├─ Narrative Fidelity
├─ Privacy / Publicability review
├─ AI processing history
└─ Source relationships어디에서 나온 콘텐츠인지 기록한다.
예:
둘은 구별한다.
Raw material
→ 사진 / 메시지 / 메모 / 로그 / 자료

Authorial draft
→ 인간이 이미 경험을 해석하여 작성한 글
Authorial draft가 존재한다면 그것이 우선한다.
AI가 raw material을 근거로 저자의 해석을 자의적으로 교정하거나 덮어써서는 안 된다.
AI가 개입했다면 필요한 범위에서 어떤 종류의 편집이 있었는지, 무엇을 일반화하거나 제거했는지,
privacy review에서 무엇을 판단했는지, 원문과 공개문 사이에 어떤 변환이 있었는지를 추적할 수 있다.
이 기록은 반드시 독자에게 공개할 필요는 없다.
목적은 AI의 창작적 월권을 방지하고 사람의 최종 판단을 돕는 것이다.
AI는 다음 역할을 수행할 수 있다.
재식별 위험과 민감정보 노출 가능성을 찾아 공개 가능한 변환을 제안한다.
저자가 이미 만든 의미와 서사를 보존하면서 문장의 명료성·구조·가독성을 개선한다.
Mode, Topic, Type 등의 후보를 제안한다.
시간에 걸쳐 반복되는 자기 패턴을 발견하고 Persona 후보를 제안한다.
설명 부족, 논리적 비약, 과도한 노출, 불필요한 반복 등을 지적한다.
AI는 다음을 하지 않는다.
Human experience / thought / observation
        ↓
Free writing
        ↓
Authorial draft
        ↓
Optional AI editorial
   ├─ Narrative Fidelity check
   ├─ Privacy / Publicability review
   ├─ Metadata suggestion
   └─ Editorial critique
        ↓
Human review
        ↓
Publish
        ↓
Canonical Content
        ↓
Activity accumulates over time
   ├─ Topic activity
   ├─ Mode patterns
   └─ Persona discovery
AI Editorial은 강력한 선택지이지만 모든 콘텐츠가 통과해야 하는 의무 단계는 아니다.
다음은 실제 콘텐츠와 사용 경험이 쌓인 뒤 결정한다.
이 항목들은 현재 Architecture의 전제가 아니다.
사람이 먼저 살아가고, 생각하고, 쓴다. AI는 그 글을 대신 살아내거나 새로운 이야기를
만드는 것이 아니라, 공개 가능하게 다듬고 시간이 지나도 발견할 수 있도록 구조화하는 일을 돕는다.
작성 경험의 원칙은 더 짧다.
Write first. Structure later.
아카이브는 현재의 나를 고정해서 보여주는 프로필이 아니다.
시간이 흐르며 관심이 이동하고, 어떤 방식으로 세상과 관계했으며, 그 과정에서 어떤 ‘나’들이
반복적으로 나타났는지를 기록하는 장기적인 개인 아카이브다.